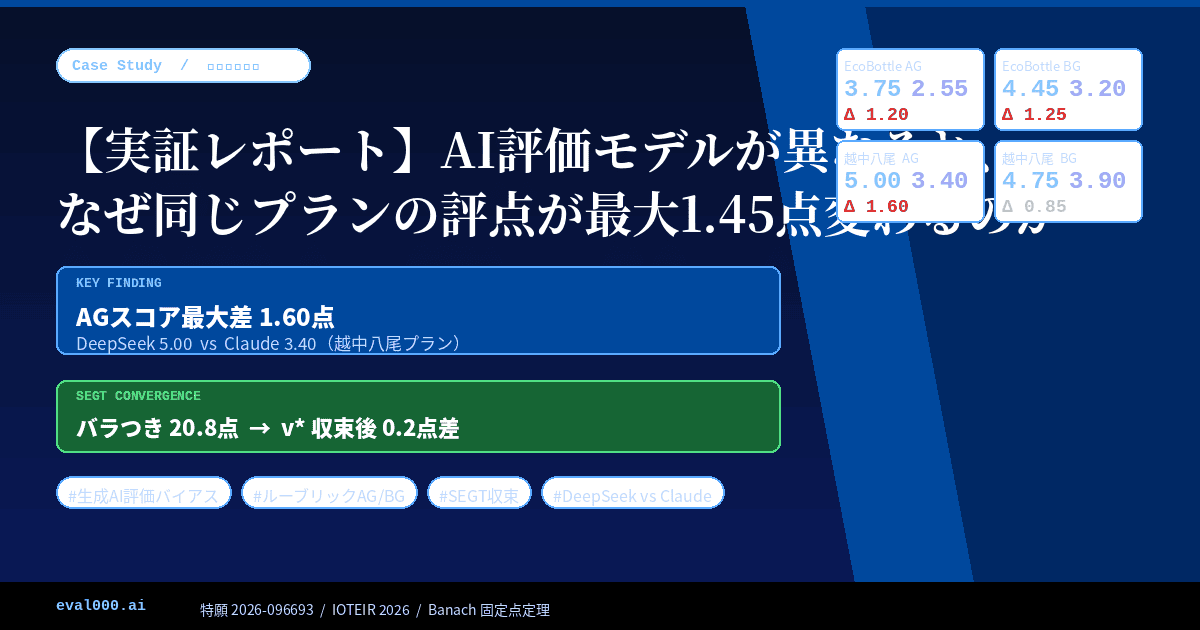
DeepSeekとClaudeに同一ルーブリック(AG/BG)で2件のビジネスプランを評価させると、AGスコアで最大1.60点差が発生しました。「将来計画を評価するか/現在の実績を評価するか」というAIの評価思想の差が、同一ルーブリックを使っても結果を変えてしまうことを実証しました。
同じ審査員・同じ基準でも生成AIの評価は最大20.8点ブレる——8月5日の体験セミナー・ライブデモの実データをもとに、SEGT収束計算がそのブレを単一の標準評価V*にまとめた実例を解説します。
(2)
(21)
(4)